RAG (Retrieval-Augmented Generation) Nedir? Yapay Zeka Projelerinde Nasıl Kullanılır?
 16.09.2026

RAG, yapay zekâ modellerinin yanıt üretmeden önce dış kaynaklardan ilgili bilgileri bulup kullanmasını sağlayan bir yaklaşımdır. Bu yazıda RAG’ın ne olduğunu, nasıl çalıştığını, hangi bileşenlerden oluştuğunu ve yapay zekâ projelerinde hangi amaçlarla kullanılabileceğini inceleyeceğiz.
RAG nedir?
RAG, İngilizce Retrieval-Augmented Generation ifadesinin kısaltmasıdır. Türkçeye “Getirme Destekli Üretim” olarak çevrilebilir. Büyük dil modellerinin yanıt üretme sürecini dış kaynaklardan alınan bilgilerle desteklemeyi amaçlar.
Bir yapay zekâ modeli, yalnızca eğitim sırasında öğrendiği bilgilerle yanıt üretmek yerine RAG yaklaşımında kendisine sunulan kaynakları da kullanabilir. Bu kaynaklar dokümanlar, web sayfaları, şirket içi bilgiler veya yapılandırılmış veriler olabilir.
RAG özellikle belirli bir bilgi kümesine dayalı yanıtların oluşturulması gereken uygulamalarda kullanışlıdır. Örneğin bir şirketin dokümanlarını anlayan ve kullanıcı sorularını bu dokümanlara göre yanıtlayan bir asistan geliştirilebilir.
RAG nasıl çalışır?
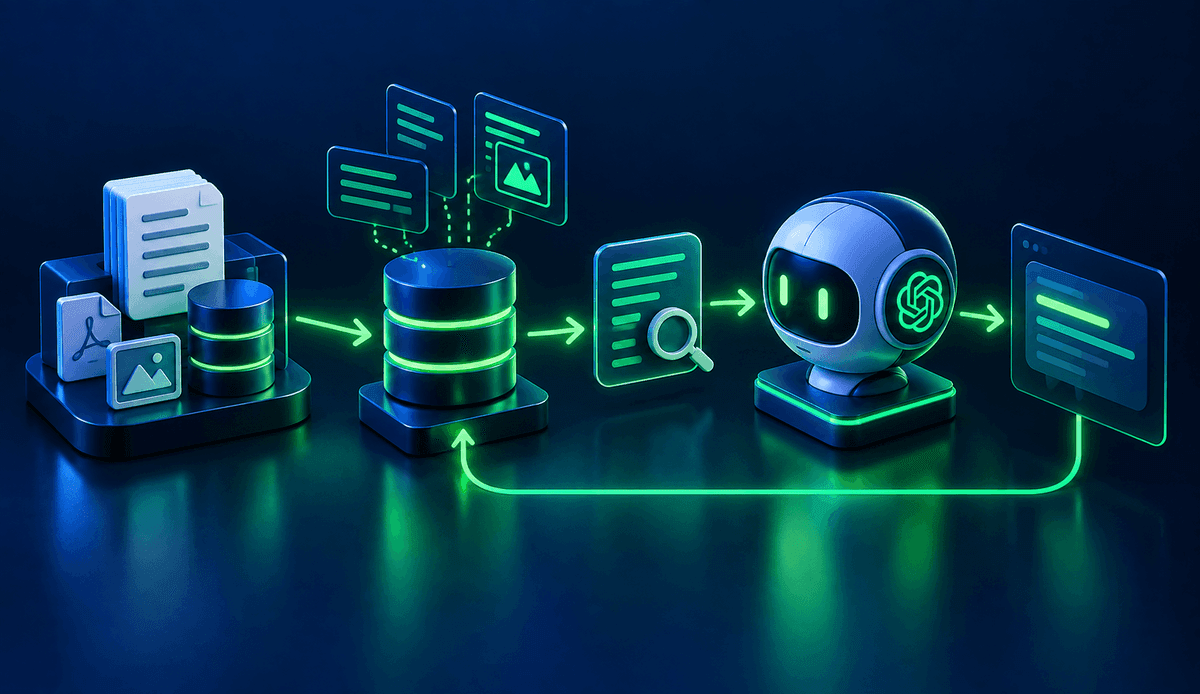
RAG sisteminin temelinde iki aşamalı bir süreç bulunur: ilgili bilginin bulunması ve bulunan bilginin yanıt üretiminde kullanılması. Kullanıcı bir soru sorduğunda sistem önce bilgi kaynakları arasında arama yapar.
Bulunan ilgili içerikler daha sonra dil modeline bağlam olarak iletilir. Model de bu bağlamı kullanarak kullanıcının sorusuna uygun bir yanıt oluşturmaya çalışır.
Basitleştirilmiş bir RAG akışı şu şekilde düşünülebilir:
- Kullanıcı bir soru sorar.
- Sistem soruyla ilişkili bilgileri arar.
- İlgili içerikler seçilir.
- Seçilen içerikler yapay zekâ modeline gönderilir.
- Model, sağlanan bağlamı kullanarak yanıt üretir.
Bu yapı sayesinde modelin yalnızca genel bilgisine bağlı kalmak yerine belirli kaynaklardan alınan bilgiler yanıt sürecine dahil edilebilir.
RAG sisteminin temel bileşenleri nelerdir?
Bir RAG mimarisinde farklı görevleri yerine getiren birkaç temel bileşen bulunur. Bu bileşenler, verinin hazırlanmasından ilgili içeriğin bulunmasına ve yanıtın oluşturulmasına kadar farklı aşamalarda görev yapar.
Başlıca bileşenler şunlardır:
- Veri kaynakları: Doküman, web sayfası, PDF veya şirket içi bilgi gibi içerikler.
- Embedding modeli: Metinleri anlamlarını temsil eden sayısal vektörlere dönüştürür.
- Vektör veritabanı: Oluşturulan vektörleri saklar ve benzer içeriklerin bulunmasına yardımcı olur.
- Retriever: Kullanıcının sorusuyla ilişkili içerikleri veri kaynağından getirir.
- Büyük dil modeli (LLM): Bulunan bilgileri kullanarak yanıt oluşturur.
Bu bileşenlerin nasıl yapılandırıldığı, RAG uygulamasının performansını ve kullanım deneyimini doğrudan etkileyebilir.
RAG ve vektör veritabanı ilişkisi nedir?
RAG sistemlerinde vektör veritabanları, ilgili bilgilerin bulunmasında önemli bir rol oynar. Metinler embedding modelleri kullanılarak sayısal vektörlere dönüştürülür ve bu vektörler veritabanında saklanabilir.
Kullanıcı bir soru sorduğunda soru da benzer şekilde vektöre dönüştürülür. Sistem, soru vektörüne anlam açısından yakın olan içerikleri arayarak ilgili bölümleri bulabilir.
Bu yöntem yalnızca aynı kelimelerin geçtiği içerikleri aramak yerine anlam bakımından benzer içeriklerin bulunmasına yardımcı olabilir.
RAG ile fine-tuning arasındaki fark nedir?
RAG ve fine-tuning, yapay zekâ modellerini belirli ihtiyaçlara uyarlamak için kullanılan farklı yaklaşımlardır. RAG, modelin yanıt üretirken harici bilgi kaynaklarına erişmesini sağlarken fine-tuning, modelin davranışını veya belirli görevlerdeki performansını değiştirmek amacıyla ek eğitim süreci uygulanmasını ifade eder.
RAG yaklaşımında bilgi kaynakları gerektiğinde güncellenebilir. Örneğin şirket dokümanlarında değişiklik olduğunda modelin yeniden eğitilmesi yerine bilgi kaynağındaki içerik güncellenebilir.
Fine-tuning ise belirli bir çıktı biçimi, görev veya davranış üzerinde çalışmak için daha uygun olabilir. Hangi yaklaşımın kullanılacağı projenin hedeflerine göre belirlenir.
RAG hangi yapay zekâ projelerinde kullanılır?
RAG, belirli bilgi kaynaklarından yararlanarak yanıt üretmesi gereken farklı yapay zekâ uygulamalarında kullanılabilir. Özellikle sürekli güncellenen veya kuruma özel bilgilerin bulunduğu projelerde değerlendirilebilir.
Yaygın kullanım alanlarından bazıları şunlardır:
- Doküman asistanları: Şirket veya proje dokümanları hakkında soruları yanıtlayan uygulamalar.
- Müşteri destek sistemleri: Ürün ve hizmet bilgilerine dayalı yanıtlar sağlayan asistanlar.
- Bilgi arama sistemleri: Büyük doküman koleksiyonlarında ilgili bilgileri bulmaya yardımcı olan uygulamalar.
- Eğitim uygulamaları: Ders materyalleri üzerinden soruları yanıtlayan sistemler.
- Kurumsal arama: Şirket içindeki farklı bilgi kaynaklarını daha erişilebilir hale getiren uygulamalar.
RAG chatbot projelerinde nasıl kullanılır?
RAG, chatbotların belirli bir bilgi kaynağı üzerinden yanıt vermesine yardımcı olabilir. Örneğin bir şirket, ürün dokümanlarını sisteme aktararak kullanıcıların bu dokümanlar hakkında doğal dille soru sorabileceği bir chatbot oluşturabilir.
Kullanıcı “Ürünün kurulumu nasıl yapılır?” gibi bir soru sorduğunda sistem öncelikle ilgili doküman bölümlerini arar. Bulduğu içerikleri dil modeline bağlam olarak gönderir ve model bu bilgiler doğrultusunda yanıt üretir.
Bu yapı, chatbotun genel konuşma yeteneğini belirli bir bilgi tabanıyla birleştirmeyi sağlar.
RAG kullanırken nelere dikkat edilmelidir?
RAG kullanmak, bir yapay zekâ sisteminin her zaman doğru yanıt vereceği anlamına gelmez. Yanıt kalitesi; kullanılan verinin doğruluğu, arama yönteminin başarısı ve modele sağlanan bağlam gibi birçok faktöre bağlıdır.
Bu nedenle RAG sistemlerinde veri hazırlama ve bilgi getirme aşamaları dikkatle tasarlanmalıdır. Özellikle dokümanların güncelliği ve kaynakların güvenilirliği düzenli olarak kontrol edilmelidir.
Ayrıca sistemin yalnızca soruyla gerçekten ilgili içerikleri modele göndermesi önemlidir. Gereğinden fazla veya alakasız içerik, modelin yanıt üretme sürecini olumsuz etkileyebilir.
RAG kullanımının avantajları nelerdir?
RAG yaklaşımının önemli avantajlarından biri, yapay zekâ uygulamalarını belirli bilgi kaynaklarıyla ilişkilendirebilmesidir. Böylece genel amaçlı bir dil modeli, uygulamanın ihtiyaç duyduğu özel içeriklerle birlikte kullanılabilir.
Öne çıkan avantajlar arasında şunlar bulunur:
- Harici bilgi kaynaklarının kullanılabilmesi
- Bilgi tabanının güncellenebilmesi
- Kuruma özel içeriklerle çalışma imkânı
- Kaynaklara dayalı yanıt üretiminin desteklenmesi
- Büyük doküman koleksiyonlarında bilgi aramanın kolaylaştırılması
RAG yapay zekâ projelerinin geleceğinde neden önemlidir?
Yapay zekâ uygulamalarının gerçek dünyadaki bilgi kaynaklarıyla birlikte çalışması giderek daha önemli hale geliyor. RAG, dil modellerinin genel yeteneklerini belirli ve güncellenebilir bilgi kaynaklarıyla bir araya getiren yöntemlerden biri olarak bu ihtiyaca yanıt verir.
Özellikle şirket içi bilgi sistemleri, doküman asistanları ve bilgi arama uygulamalarında RAG yaklaşımı değerlendirilebilir. Ancak başarılı bir sistem için yalnızca dil modeline değil, veri kalitesine ve bilgi getirme sürecine de odaklanmak gerekir.
RAG, yapay zekâ modellerinin dış kaynaklardan bilgi alarak daha bağlama uygun yanıtlar üretmesini sağlayan bir yaklaşımdır. Vektör veritabanları, embedding modelleri ve LLM’lerle birlikte çalışan RAG; chatbot, kurumsal arama ve doküman asistanı gibi birçok projede kullanılabilir.